Si llegaste hasta acá es porque tenés alguna página que no querés que aparezca en los resultados de Google: una versión de prueba, una landing duplicada, los resultados de búsqueda interna de tu propio sitio o contenido que preferís mantener fuera del índice. Existen varias formas de lograrlo, pero no todas sirven para lo mismo, y usar la equivocada puede terminar logrando justo lo contrario de lo que buscabas: que la página siga apareciendo, pero peor.
En esta guía repasamos cómo evitar que Google indexe una página: los métodos reales, cuándo conviene usar cada uno y un error de orden que hace que la página siga indexada aunque hayas «hecho todo bien».
Evitar que Google indexe una página: noindex y robots.txt no son lo mismo
Antes de elegir un método, conviene tener clara una distinción, porque de ella depende que cualquiera de los métodos funcione: rastrear una página e indexarla no son la misma cosa.
Google rastrea una URL cuando su bot la visita y lee su contenido. La indexa cuando decide guardarla en su base de datos para poder mostrarla en los resultados de búsqueda. El archivo robots.txt controla el rastreo: le dice a Google qué URLs puede visitar. La etiqueta noindex controla la indexación: le dice a Google que, aunque la visite, no la guarde en el índice.
El problema aparece cuando se combinan mal. Si bloqueás una URL en robots.txt, Google nunca la va a rastrear, y si nunca la rastrea, tampoco puede leer la etiqueta noindex que pusiste en esa misma página. El resultado, contraintuitivo pero real, es que la página puede seguir apareciendo en los resultados (sin descripción, con la leyenda «No hay información disponible sobre esta página») en lugar de desaparecer del todo.
Con esto claro, veamos los métodos disponibles y para qué sirve cada uno.
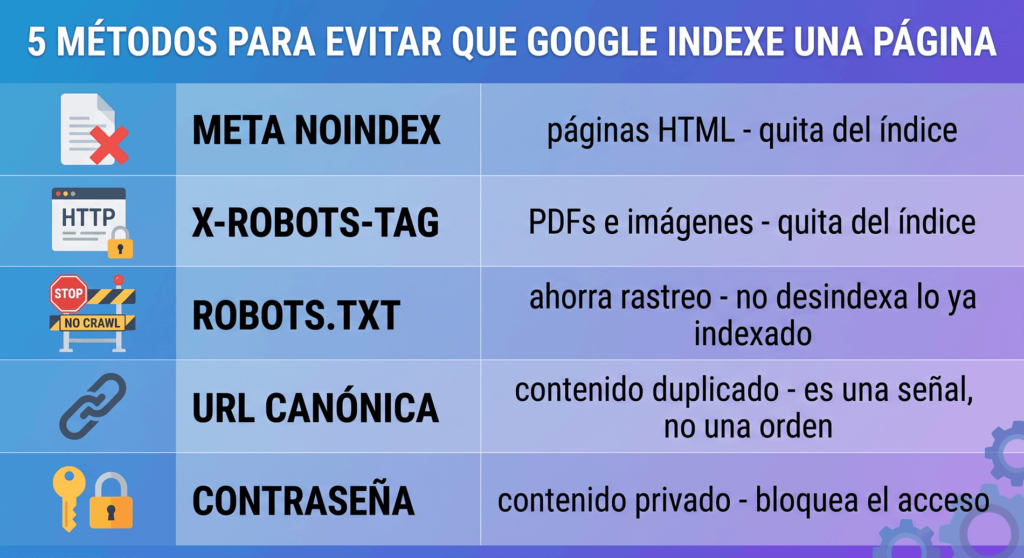
Método 1: la etiqueta meta noindex
Es la forma más directa y confiable de sacar una página del índice de Google. Consiste en agregar esta línea dentro del <head> del HTML de la página:
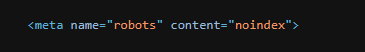
Cuando Googlebot rastrea la página y encuentra esta etiqueta, descarta la URL del índice en la siguiente actualización. No es instantáneo (puede tardar desde un par de días hasta unas semanas, según con qué frecuencia Google rastree esa sección del sitio), pero es el método que Google recomienda de forma explícita para páginas HTML individuales.
¿Google respeta siempre la etiqueta noindex?
Sí, Google se adhiere a la directiva noindex cuando puede acceder a leerla, y ese es el punto clave: la etiqueta solo funciona si Google puede entrar a la página. Volvemos al apartado anterior: si robots.txt la está bloqueando, la etiqueta nunca se llega a ver. Por eso, cuando parece que noindex «no funciona», lo primero que hay que revisar es si robots.txt bloquea esa URL.
Método 2: el encabezado X-Robots-Tag
La meta etiqueta noindex funciona en páginas HTML, pero no sirve para archivos como PDFs, imágenes o documentos. Para esos casos, la alternativa es el encabezado HTTP X-Robots-Tag, que cumple la misma función pero se configura a nivel de servidor en lugar de en el código HTML.
Esto lo hace especialmente útil cuando querés bloquear en bloque un tipo de archivo completo (todos los PDFs de una carpeta, por ejemplo) sin tener que tocar cada uno de forma individual. Si tu caso puntual son archivos PDF, ya escribí una guía específica sobre cómo evitar que Google indexe archivos PDF, con el código exacto para .htaccess según el servidor que uses.
Cómo desindexar imágenes
Las imágenes son un caso particular porque no tienen un <head> donde insertar una meta etiqueta: la etiqueta noindex directamente no existe para un archivo .jpg o .png. Ahí es donde entra el X-Robots-Tag: configurado a nivel de servidor para esa extensión de archivo, cumple la misma función que el noindex pero aplicado a imágenes.
Si la imagen ya está indexada en Google Imágenes, además del X-Robots-Tag conviene quitarla del sitemap de imágenes (si el sitio tiene uno) y, si hace falta que desaparezca con urgencia, usar la misma herramienta de Retirada de URLs de Search Console que veremos más adelante, apuntando directamente a la URL de la imagen.
Método 3: robots.txt, cuándo sí conviene usarlo
Ya vimos que robots.txt no sirve para desindexar una página que ya está en el índice. Pero eso no lo vuelve inútil: su función real es otra, y bien usado tiene sentido en casos concretos.
Robots.txt sirve para decirle a Google que ni siquiera pierda tiempo rastreando ciertas secciones: paneles de administración, carpetas internas, parámetros de URL duplicados o sitios enteros en fase de desarrollo. Ahí no hay una página indexada que sacar del índice, sino tráfico de rastreo que preferís ahorrarle al bot (lo que en SEO se conoce como cuidar el crawl budget, sobre todo en sitios grandes).
La regla práctica es esta: si la página todavía no está indexada y querés que nunca lo esté, robots.txt puede ser suficiente. Si la página ya está indexada, necesitás la etiqueta noindex (y que el robots.txt no la esté bloqueando) para sacarla.
¿Se puede bloquear una carpeta entera de una sola vez?
Sí. Tanto robots.txt (para el rastreo) como el X-Robots-Tag configurado por tipo de archivo o carpeta en el servidor (para la indexación) permiten aplicar la regla a nivel masivo, sin editar página por página.
Método 4: la URL canónica, para duplicados, no para desindexar
Cuando tenés varias URLs con contenido igual o muy similar (versiones con y sin parámetros, con y sin barra final, filtros de una tienda online), la etiqueta canonical le indica a Google cuál es la versión «oficial» que querés que se muestre en los resultados.
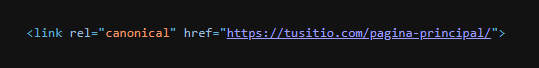
Es importante no confundir esto con noindex: el canonical no elimina páginas del índice, es una señal de preferencia entre duplicados. Google normalmente la respeta, pero no es una instrucción tan estricta como noindex. Si tu objetivo es directamente que una URL desaparezca de los resultados, esta no es la herramienta.
Método 5: proteger la página con contraseña
Es la opción más drástica: si una página requiere autenticación para verse, Google no puede acceder a ella ni indexarla, punto. Tiene sentido para contenido genuinamente privado (áreas de clientes, borradores, documentación interna), pero no es una solución práctica para páginas públicas que simplemente no querés que aparezcan en Google, porque también les bloquea el acceso a tus propios visitantes.
Cómo poner noindex en WordPress
Si tu sitio corre en WordPress, no hace falta tocar código a mano: plugins de SEO como Yoast SEO y Rank Math lo resuelven con un clic, página por página.
Con Yoast SEO
Al editar la entrada o página, bajá hasta el bloque de Yoast SEO y entrá en la pestaña Avanzado. Ahí vas a encontrar la opción que pregunta si los motores de búsqueda pueden mostrar esa página en los resultados: seleccioná «No» y Yoast agrega automáticamente la etiqueta noindex a esa URL.
Con Rank Math
El proceso es equivalente: en el panel de Rank Math dentro del editor, abrí la pestaña Advanced, buscá la sección «Robots Meta» y tildá «No Index». Si no ves la pestaña Advanced, activá el Modo Avanzado en los ajustes generales de Rank Math.
En ambos casos, conviene revisar también la configuración global del plugin (Ajustes de motores de búsqueda), porque a veces categorías, etiquetas o resultados de búsqueda interna quedan indexados por defecto sin que nadie lo haya decidido a propósito.
El error que hace que una página siga indexada igual
Ya lo mencionamos, pero vale la pena remarcarlo como sección aparte porque es lo que hace que alguien «haga todo bien» y la página no desaparezca: combinar noindex con un bloqueo en robots.txt sobre la misma URL.
Si tu plan es sacar del índice una página que ya está indexada, el orden correcto es: primero agregás la etiqueta noindex y te asegurás de que robots.txt no esté bloqueando esa URL, esperás a que Google la rastree de nuevo y la desindexe, y recién ahí, si además querés ahorrar rastreo futuro sobre esa sección, podés sumar el bloqueo en robots.txt. Hacerlo en el orden inverso es justo la trampa.
Si la página ya está indexada: cómo eliminarla desde Search Console
La etiqueta noindex funciona, pero no es inmediata. Si necesitás que una página desaparezca de los resultados con urgencia (por ejemplo, se filtró contenido que no debía publicarse), Google Search Console tiene una herramienta para eso: «Retirada de URLs», dentro de la sección Indexación del menú lateral.
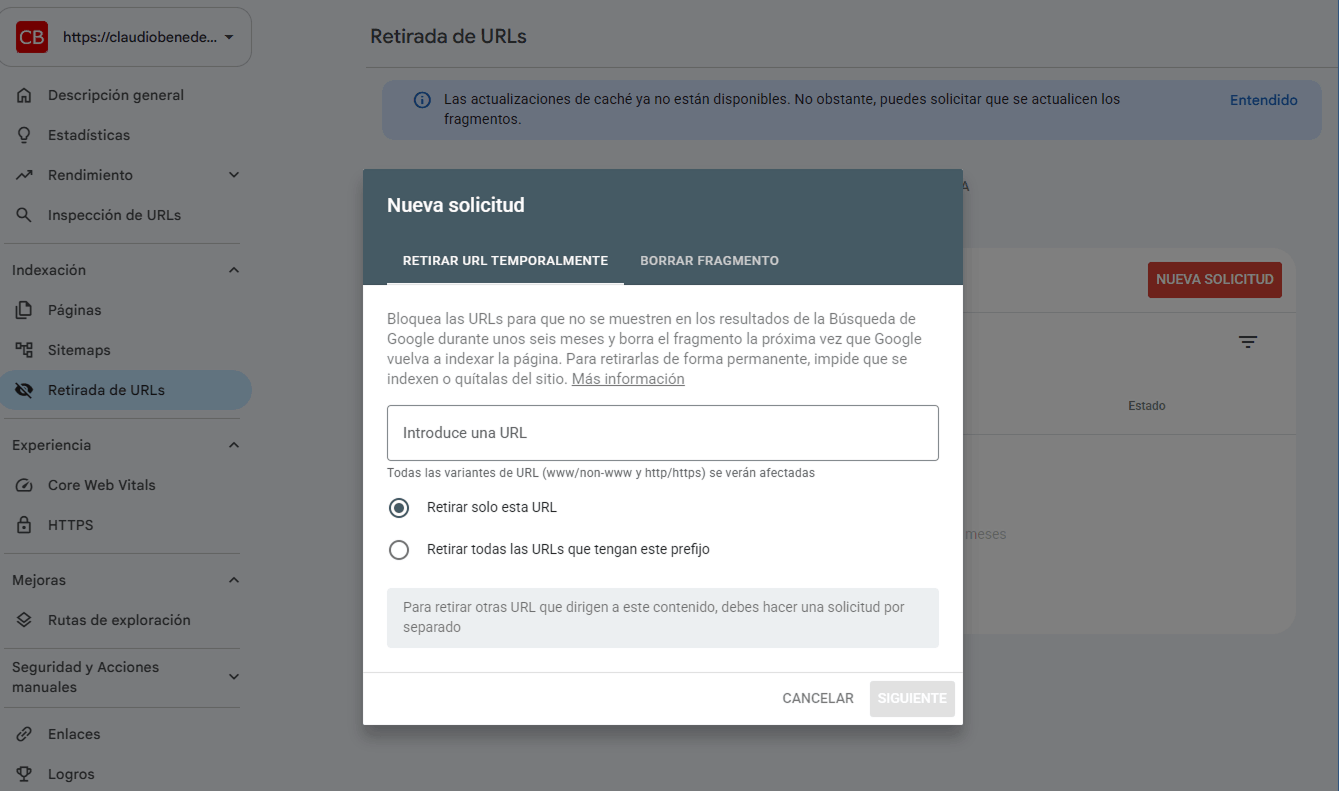
Ahí podés pedir un ocultamiento temporal (unos seis meses) de una URL específica mientras la solución definitiva —el noindex, el bloqueo por contraseña, o directamente borrar la página— surte efecto. Es importante entender que esta herramienta no es un reemplazo de los métodos anteriores: es un parche rápido, no una solución permanente. Si no resolvés la causa de fondo, la página vuelve a aparecer cuando se cumple el plazo.
Verificá que funcionó antes de dar el tema por cerrado
Después de aplicar cualquiera de los métodos, no alcanza con esperar y confiar. La herramienta de inspección de URLs de Search Console te muestra si Google ya detectó la directiva noindex en esa página, y la sección de indexación de páginas te permite seguir cuándo sale del índice. Si pasadas unas semanas sigue apareciendo, volvé al apartado del error de orden y revisá primero si hay un bloqueo en robots.txt que impida a Google leer la etiqueta.